

✅ Artigo atualizado em Setembro 2026 (beautifulsoup4 4.15 e requests 2.34) Todos os exemplos foram executados de novo e migrados para sites feitos para praticar scraping (quotes.toscrape.com e books.toscrape.com), porque o HTML do Python.org mudou. Novas seções de seletores CSS, extração de texto e atributos, paginação, erros comuns com traceback e 8 exercícios resolvidos.
Resposta rápida
Para fazer web scraping com Python, baixe o HTML com requests.get(url) e entregue o conteúdo ao BeautifulSoup: soup = BeautifulSoup(html, "html.parser"). Depois localize os dados com find() (primeiro elemento), find_all() (todos) ou select() (seletor CSS).
1
2
3
4
5
6
7

import requests
from bs4 import BeautifulSoup

resposta = requests.get("https://quotes.toscrape.com/", timeout=10)
soup = BeautifulSoup(resposta.text, "html.parser")
print(soup.find("small", class_="author").text)  # Albert Einstein
print(len(soup.select("div.quote")))             # 10
Resumo em 30 segundos:
- Instale com
pip install requests beautifulsoup4e importe comfrom bs4 import BeautifulSoup. -
requestsbaixa a página; o BeautifulSoup só interpreta o HTML (não acessa a internet nem executa JavaScript). -
find()devolve o primeiro elemento ouNone;find_all()eselect()devolvem uma lista (vazia se não achar). - Texto com
tag.get_text(strip=True); atributos comtag["href"]outag.get("href"). - Use
timeout,raise_for_status(), pausas entre requisições e respeite o robots.txt e os termos de uso do site.
Salve salve Pythonista!
Hoje, vamos navegar pelo maravilhoso mundo do Web Scraping utilizando a popular biblioteca Python, o BeautifulSoup.
Ao longo deste artigo, vamos visitar temas importantes, como Crawler, Parser, o uso de BeautifulSoup, seus principais métodos, seletores CSS e paginação e, finalmente, vamos colocar a mão na massa com um mini projeto, erros comuns e exercícios resolvidos!
Vá Direto ao Assunto…
- O que é web scraping com Python
- Crawler e Parser
- BeautifulSoup: Seu Amigo na Coleta de Dados
- Principais métodos de utilização do BeautifulSoup
- find() vs select(): seletores CSS no BeautifulSoup
- Bot de Web Scraping com BeautifulSoup
- Como raspar várias páginas (paginação)
- BeautifulSoup vs Outras Bibliotecas
- Quando NÃO Usar BeautifulSoup
- Casos de Uso Avançados
- Boas Práticas
- Erros comuns
- Exercícios resolvidos
O que é web scraping com Python
Web scraping (ou raspagem de dados) é a coleta automática de informações de páginas da web: um programa baixa o HTML de uma página, encontra os trechos que interessam (preços, títulos, links, tabelas) e salva esses dados em um formato útil, como uma lista, um CSV ou um JSON.
Em Python, o fluxo mais comum tem três passos:
-
Baixar a página com
requests.get(url). -
Interpretar o HTML com
BeautifulSoup(html, "html.parser"). -
Extrair os dados com
find(),find_all()ouselect()e guardar o resultado.
Se você quer entender o conceito com mais calma (e quando usar uma API em vez de raspar), leia antes o artigo o que é Web Scraping e para que serve.
Primeiro, vamos começar do início. Pelos conceitos de Crawler e Parser!
Crawler e Parser
Um Crawler, também conhecido como Spider, é um tipo de script que realiza a varredura na web de maneira metódica e automatizada.
Ele serve para coletar recursos específicos, como, por exemplo, links ou dados específicos de páginas da web.
Suponha que a Página A contenha um link para a Página B e que a Página B possua um link para a Página C.
Através da leitura do código HTML, podemos - de forma automatizada - traçar esse “caminho”, saindo da Página A à Página C, passando pela Página B.
Para isso, basta analisar o código HTML da Página A, em busca de tags <a>, como por exemplo:
1

<a href="https://paginab.com.br">Página B</a>
E em seguida, realizar a mesma operação na Página B, em busca de outra tag <a> que faz referência à Página C, por exemplo:
1

<a href="https://paginac.com.br">Página C</a>
Assim como uma aranha “navega” em sua rede, um processo Spider (ou Crawler) navega na “Net” (que significa Rede, em Inglês)!
Já o Parser é uma ferramenta que nos ajuda a extrair dados de um documento. No mundo do Web Scraping, ele é comumente usado para extrair dados de páginas HTML e XML.
No processo de Parsing, algum programa irá “digerir” os dados “esquisitos” de uma página HTML para uma representação mais simples de ser compreendida e processada, possibilitando a busca e extração de dados!
Esse dois processos (Crawler e Parser) são muito importantes no contexto do Web Scraping.
BeautifulSoup: Seu Amigo na Coleta de Dados
O BeautifulSoup é uma biblioteca Python que facilita a raspagem de informações das páginas da web.
Ele possui um poderoso parser que proporciona uma maneira Pythonica de navegar, pesquisar e modificar os dados de um Website.
Para utilizá-lo, utilize o pip e instale o BeautifulSoup em um ambiente virtual (se ainda não sabe o que são ambientes virtuais, clique aqui e aprenda a utilizar o Virtualenv):
1

pip install beautifulsoup4
Atenção ao nome: o pacote instalado se chama beautifulsoup4, mas no código o import é from bs4 import BeautifulSoup.
Uma coisa importante a notar aqui é que o BeautifulSoup não baixa as páginas da web para nós. Por isso ele geralmente é utilizado com a biblioteca requests para buscar o código HTML de uma página web (instale-o no mesmo ambiente virtual com pip install requests).
A referência completa de métodos está na documentação oficial do Beautiful Soup e na documentação do requests.
Sabendo disso, vamos em frente.
Mas antes… Está curtindo esse conteúdo? 
Que tal receber 30 dias de conteúdo direto na sua Caixa de Entrada?
Principais métodos de utilização do BeautifulSoup
Antes de começarmos a usar o BeautifulSoup, devemos dar uma olhada em seus principais métodos:
-
find()efind_all(): Esses dois métodos são usados frequentemente para encontrar tags. O métodofind_all()busca todas as instâncias de uma tag efind()busca apenas a primeira instância de uma tag. -
select()eselect_one(): Fazem a mesma busca usando seletores CSS (comodiv.quote span.text).select()devolve uma lista eselect_one()devolve o primeiro resultado. -
get(): Este método é usado para acessar os atributos de uma tag. -
texteget_text(): Obtêm o texto de dentro de uma tag. Comget_text(strip=True)você já remove os espaços das pontas.
Agora que conhecemos o básico, vamos utilizar o BeautifulSoup para um exemplo simples de WebScraping, no site quotes.toscrape.com, que foi criado justamente para quem quer praticar scraping:
1
2
3
4
5
6
7
8
9
10

from bs4 import BeautifulSoup
import requests

URL = 'https://quotes.toscrape.com/'
page = requests.get(URL, timeout=10)

soup = BeautifulSoup(page.content, 'html.parser')

header = soup.find('h1')
print(header)
Se você rodar este script, ele retornará o que há dentro da primeira tag <h1> que encontrar na página:
1
2
3

<h1>
<a href="/" style="text-decoration: none">Quotes to Scrape</a>
</h1>
find() vs select(): seletores CSS no BeautifulSoup
Os dois estilos encontram os mesmos elementos. A diferença está em como você descreve o que procura:
-
find()/find_all(): você passa o nome da tag e filtros como argumentos (class_="preco",id="vitrine",href=True). -
select()/select_one(): você escreve um seletor CSS, o mesmo que usaria numa folha de estilo ou no DevTools do navegador (#vitrine .preco,div.produto > h2).
Veja os dois lado a lado, com um HTML embutido no próprio código (roda sem internet):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26

from bs4 import BeautifulSoup

html = """
<div id="vitrine">
  <div class="produto destaque">
    <h2>Teclado</h2>
    <span class="preco">R$ 150,00</span>
    <a href="/produtos/teclado" title="Ver teclado">detalhes</a>
  </div>
  <div class="produto">
    <h2>Mouse</h2>
    <span class="preco">R$ 80,00</span>
    <a href="/produtos/mouse">detalhes</a>
  </div>
</div>
"""
soup = BeautifulSoup(html, "html.parser")

# find / find_all: nome da tag + filtros
print(soup.find("h2").text)                                 # Teclado
print([h.text for h in soup.find_all("h2")])                # ['Teclado', 'Mouse']
print(soup.find("div", class_="destaque").h2.text)          # Teclado

# select / select_one: seletores CSS
print(soup.select_one("div.produto.destaque h2").text)      # Teclado
print([p.text for p in soup.select("#vitrine .preco")])     # ['R$ 150,00', 'R$ 80,00']
Regra prática: para buscas simples, find() é mais legível; quando o caminho envolve vários níveis (“o h2 dentro da div com duas classes dentro de #vitrine”), select() resolve em uma linha. Uma dica útil: no DevTools do Chrome ou do Firefox, clique com o botão direito no elemento e use Copiar > Copiar seletor para ter um ponto de partida.
| Situação | Use |
|---|---|
| Primeiro elemento com uma tag/classe | soup.find("span", class_="preco") |
| Todos os elementos com uma tag/classe | soup.find_all("span", class_="preco") |
| Caminho com vários níveis ou várias classes | soup.select("div.produto.destaque h2") |
| Primeiro elemento de um seletor CSS | soup.select_one("#vitrine .preco") |
| Só tags que têm um atributo |
soup.find_all("a", href=True) ou soup.select("a[href]")
|
Como extrair texto e atributos
Encontrar a tag é metade do trabalho. A outra metade é tirar dela o texto ou um atributo (como o href de um link ou o src de uma imagem):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16

from bs4 import BeautifulSoup

html = '<p class="info">  Frete <b>grátis</b> acima de R$ 99  </p><a href="/ofertas" title="Ofertas">ver</a>'
soup = BeautifulSoup(html, "html.parser")

p = soup.find("p")
print(repr(p.text))                    # '  Frete grátis acima de R$ 99  '
print(p.get_text(strip=True))          # Fretegrátisacima de R$ 99
print(p.get_text(" ", strip=True))     # Frete grátis acima de R$ 99

link = soup.find("a")
print(link["href"])                    # /ofertas
print(link.get("title"))               # Ofertas
print(link.get("target"))              # None (atributo não existe)
print(link.attrs)                      # {'href': '/ofertas', 'title': 'Ofertas'}
print(p["class"])                      # ['info'] (class sempre vem como lista)
Repare na linha 8: get_text(strip=True) remove os espaços de cada pedaço de texto e cola tudo, o que junta as palavras quando há tags no meio (<b>). Passe um separador, como em get_text(" ", strip=True), para manter as palavras separadas.
Bot de Web Scraping com BeautifulSoup
Finalmente, estamos prontos para começar a trabalhar em nosso mini projeto!
Vamos criar um simples bot de raspagem para extrair citações, autores e links do site quotes.toscrape.com (nas primeiras versões deste artigo o alvo era o blog do Python.org, mas o HTML dele mudou e o exemplo parou de funcionar - um lembrete de que scrapers quebram quando o site muda).
O primeiro passo para qualquer projeto de Web Scraping é analisar o código HTML da página de onde se quer extrair os dados.
Com a ajuda das Ferramentas de Desenvolvedor do Navegador (Chrome ou Firefox, por exemplo), podemos passar o mouse em cima da região onde queremos extrair os dados e analisar a estrutura do código HTML. Veja como fica essa inspeção no DevTools:
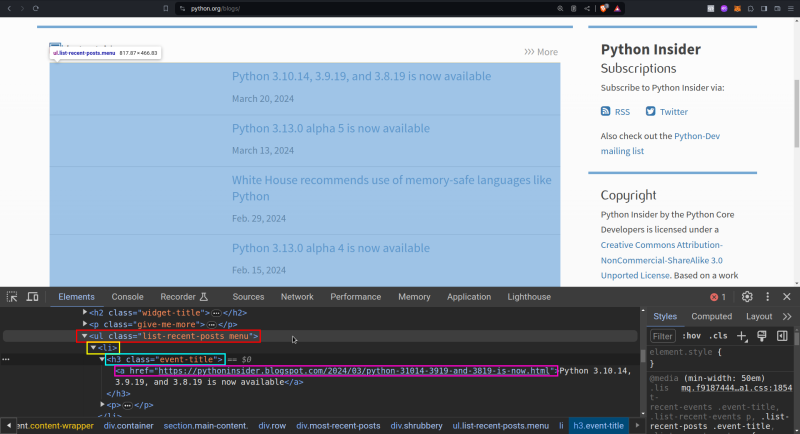
No quotes.toscrape.com, fazendo a mesma inspeção, cada citação tem esta estrutura (resumida):
1
2
3
4
5
6

<div class="quote">
  <span class="text">“The world as we have created it...”</span>
  <span>by <small class="author">Albert Einstein</small>
  <a href="/author/Albert-Einstein">(about)</a>
  </span>
</div>
Dessa forma, sabemos que o que queremos está: dentro de uma <div> com a classe CSS quote, que contém o texto em um <span class="text">, o autor em um <small class="author"> e um link <a> para a página do autor.
Com isso podemos buscar os dados que queremos da seguinte forma:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18

from bs4 import BeautifulSoup
import requests

URL = 'https://quotes.toscrape.com/'
page = requests.get(URL, timeout=10)
page.raise_for_status()

soup = BeautifulSoup(page.content, 'html.parser')

# Cada citação fica em uma <div class="quote">
citacoes = soup.find_all('div', class_='quote')

# Imprimimos as 3 primeiras: texto, autor e link da página do autor
for citacao in citacoes[:3]:
    texto = citacao.find('span', class_='text').get_text(strip=True)
    autor = citacao.find('small', class_='author').text
    link = citacao.find('a')['href']
    print(f"{autor}: {texto[:50]}...\n  Link: {link}")
Este script irá acessar a página e imprimirá as citações em um formato de texto limpo:
1
2
3
4
5
6

Albert Einstein: “The world as we have created it is a process of o...
  Link: /author/Albert-Einstein
J.K. Rowling: “It is our choices, Harry, that show what we truly...
  Link: /author/J-K-Rowling
Albert Einstein: “There are only two ways to live your life. One is...
  Link: /author/Albert-Einstein
Muito maneiro não é mesmo?!
Repare que o link veio relativo (/author/Albert-Einstein). Para montar a URL completa, use urljoin do módulo urllib.parse, como no exemplo de paginação logo abaixo.
Agora, se quiser aprender mais ainda sobre Web Scraping, eu posso te ajudar!
Em nosso primeiro Projeto da Jornada Python, o curso de Python completo da Python Academy, você vai aprender a buscar dados financeiros na internet para criar uma estratégia de investimentos para você!
Além disso, você vai aprender Python do básico ao avançado através de projetos completos e muito exercício.
E não para por aí: você ainda vai aprender a desenvolver aplicações Web utilizando o famoso framework Django!
Tudo isso com suporte às suas dúvidas, Comunidade Exclusiva de Alunos, certificado de conclusão, e-books exclusivos e muito mais!
Estou construindo o Ebookr.ai, uma plataforma onde você cria ebooks profissionais com IA sobre qualquer assunto - do zero ao PDF pronto, com capas e infográficos gerados automaticamente. Dá uma olhada!
Te vejo na Jornada, caro Pythonista!
Como raspar várias páginas (paginação)
Quase todo site com listagens divide o conteúdo em páginas. O padrão é sempre o mesmo: raspe a página atual, procure o link “Próxima” e repita até ele não existir mais.
No quotes.toscrape.com, o link para a próxima página fica em <li class="next"><a href="/page/2/">. O script abaixo percorre todas as páginas e conta quantos autores diferentes existem no site:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25

import time
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup

url = "https://quotes.toscrape.com/"
autores = set()
paginas = 0

while url:
    resposta = requests.get(url, timeout=10)
    resposta.raise_for_status()
    soup = BeautifulSoup(resposta.text, "html.parser")
    paginas += 1

    for autor in soup.select("div.quote small.author"):
        autores.add(autor.get_text(strip=True))

    proximo = soup.select_one("li.next > a")        # None na última página
    url = urljoin(url, proximo["href"]) if proximo else None
    time.sleep(1)                                     # pausa educada entre páginas

print(f"Páginas visitadas: {paginas}")
print(f"Autores diferentes: {len(autores)}")
Saída (em setembro de 2026):
1
2

Páginas visitadas: 10
Autores diferentes: 50
Três detalhes fazem diferença:
-
urljointransforma ohrefrelativo (/page/2/) em URL completa, sem você concatenar strings na mão. -
select_one()devolveNonena última página, e é isso que encerra owhile. -
time.sleep(1)evita disparar dezenas de requisições por segundo contra o servidor.
Quando o site tem a URL previsível (/page/1/, /page/2/…), também dá para usar um for com range(). E se forem milhares de páginas, vale conhecer a programação assíncrona no Python ou partir para o Scrapy, sempre com limite de requisições simultâneas.
Conclusão
Neste artigo você aprendeu sobre web scraping com Python e BeautifulSoup. Discutimos sobre Crawler e Parser, conhecemos melhor a biblioteca BeautifulSoup e até construímos um simples bot de raspagem.
A combinação de Python e BeautifulSoup torna o web scraping acessível, até mesmo para programadores menos experientes.
Com um pouco de prática, você pode começar a extrair uma grande quantidade de dados da web, que podem ser usados para análise de dados, aprendizado de máquina e uma variedade de outras aplicações.
BeautifulSoup vs Outras Bibliotecas
Quando usar cada ferramenta:
| Critério | requests + BeautifulSoup | Selenium | Playwright | Scrapy |
|---|---|---|---|---|
| O que é | Download HTTP + parser de HTML | Automação de navegador real | Automação de navegador real | Framework completo de crawling |
| Executa JavaScript | Não | Sim | Sim | Não (só com extensões) |
| Facilidade | Muito fácil | Média | Média | Curva maior |
| Velocidade | Rápida (não abre navegador) | Lenta (abre navegador) | Lenta (abre navegador) | Rápida (requisições concorrentes) |
| Muitas páginas | Loop manual | Loop manual | Loop manual | Nativo: fila de URLs, retry, exportação |
| Uso ideal | Sites estáticos, scripts pequenos, aprender | Sites com JavaScript, automações legadas | Sites com JavaScript, SPAs, login e cliques | Crawling em escala e projetos recorrentes |
Quando NÃO Usar BeautifulSoup
❌ Site usa JavaScript pesado Use Selenium ou Playwright em vez disso (veja web scraping com IA, LangChain e Playwright)
❌ Precisa scraping em grande escala O Scrapy foi feito para isso: requisições concorrentes, fila de URLs, retry e exportação já vêm prontos
❌ Site tem API oficial Sempre prefira APIs quando disponíveis
❌ Site bloqueia scraping agressivamente É um sinal de que o dono do site não quer a coleta automatizada: releia os termos de uso e procure uma API ou outra fonte de dados antes de insistir
Casos de Uso Avançados
1. Scraping com Headers Personalizados
Muitos sites respondem de forma diferente conforme o cabeçalho User-Agent. O requests se identifica como python-requests/versão por padrão; o mais transparente é identificar o seu script e deixar um contato:
1
2
3
4
5
6
7
8
9
10
11
12
13
14

import requests
from bs4 import BeautifulSoup

# Identifique seu script e diga como falar com você
headers = {
    'User-Agent': 'MeuScraperDeEstudos/1.0 (contato: [email protected])',
    'Accept': 'text/html,application/xhtml+xml',
    'Accept-Language': 'pt-BR,pt;q=0.9',
}

response = requests.get('https://books.toscrape.com/', headers=headers, timeout=10)
response.raise_for_status()
soup = BeautifulSoup(response.content, 'html.parser')
print(response.status_code, len(soup.select('article.product_pod')))  # 200 20
2. Tratamento de Erros Robusto
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20

import requests
from bs4 import BeautifulSoup
import time

def scrape_com_retry(url, max_tentativas=3):
    """Scraping com retry automático em caso de falha"""
    for tentativa in range(max_tentativas):
        try:
            response = requests.get(url, timeout=10)
            response.raise_for_status()  # Lança HTTPError se o status for 4xx ou 5xx

            soup = BeautifulSoup(response.content, 'html.parser')
            return soup

        except requests.RequestException as e:
            print(f"Tentativa {tentativa + 1} falhou: {e}")
            if tentativa < max_tentativas - 1:
                time.sleep(2 ** tentativa)  # Backoff exponencial
            else:
                raise
Se o try/except ainda é novidade, veja o guia de tratamento de erros e exceções no Python.
3. Extração de Dados Estruturados
O objetivo final quase sempre é uma lista de dicionários, pronta para virar CSV, JSON ou DataFrame. Exemplo com a vitrine do books.toscrape.com, uma loja fictícia feita para praticar:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29

from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup

NOTAS = {'One': 1, 'Two': 2, 'Three': 3, 'Four': 4, 'Five': 5}

def extrair_livros(url):
    """Extrai nome, preço, nota e link de cada livro da página"""
    response = requests.get(url, timeout=10)
    response.raise_for_status()
    soup = BeautifulSoup(response.content, 'html.parser')

    livros = []
    for card in soup.select('article.product_pod'):
        link = card.select_one('h3 a')
        preco = card.select_one('p.price_color').get_text(strip=True)
        classes_nota = card.select_one('p.star-rating')['class']  # ['star-rating', 'Three']
        livros.append({
            'nome': link['title'],
            'preco': float(preco.replace('£', '')),
            'nota': NOTAS[classes_nota[1]],
            'link': urljoin(url, link['href']),
        })
    return livros

livros = extrair_livros('https://books.toscrape.com/')
print(len(livros))
print(livros[0])
Saída:
1
2

20
{'nome': 'A Light in the Attic', 'preco': 51.77, 'nota': 3, 'link': 'https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html'}
Repare que o nome completo do livro veio do atributo title do link (o texto visível é cortado com “…”) e a nota veio de uma classe CSS (star-rating Three). Para salvar o resultado, veja como gravar dados em arquivos CSV com Python ou manipular JSON no Python.
Web scraping vira ferramenta de verdade quando entra num projeto maior - com tratamento de erro, boas práticas e código organizado por trás. É esse tipo de projeto completo que você constrói na Jornada Python:
Domine Python: A Linguagem da Inteligência Artificial, do Desenvolvimento Web e das Carreiras do Futuro.
A mais completa formação para você se tornar um especialista em Python, pronto para construir desde aplicações web robustas com Django até projetos de Inteligência Artificial e Ciência de Dados .
Boas Práticas
✅ Use parsers adequados
-
html.parser- Built-in, sem dependências -
lxml- Mais rápido, requer instalação -
html5lib- Mais tolerante a HTML malformado
✅ Respeite robots.txt
O arquivo robots.txt diz quais caminhos o dono do site pede que robôs não acessem. O Python já traz um leitor pronto, o urllib.robotparser:
1
2
3
4
5
6
7
8
9

import urllib.robotparser

rp = urllib.robotparser.RobotFileParser()
rp.set_url('https://www.python.org/robots.txt')
rp.read()

print(rp.can_fetch('*', 'https://www.python.org/downloads/'))  # True
print(rp.can_fetch('*', 'https://www.python.org/webstats/'))   # False
print(rp.crawl_delay('*'))                                     # None (sem Crawl-delay definido)
✅ Leia os termos de uso e cuidado com dados pessoais
- Muitos sites proíbem coleta automatizada nos termos de uso; prefira a API oficial quando ela existir.
- Evite coletar dados pessoais (nomes, e-mails, telefones) sem base legal: no Brasil, a LGPD se aplica a esses dados mesmo quando estão públicos.
- Não republique conteúdo protegido por direito autoral como se fosse seu.
✅ Implemente rate limiting
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22

import time

import requests

class RateLimiter:
    def __init__(self, requests_por_segundo=1):
        self.delay = 1.0 / requests_por_segundo
        self.last_request = 0

    def wait(self):
        elapsed = time.time() - self.last_request
        if elapsed < self.delay:
            time.sleep(self.delay - elapsed)
        self.last_request = time.time()

# Uso
urls = [f'https://quotes.toscrape.com/page/{n}/' for n in range(1, 4)]
limiter = RateLimiter(requests_por_segundo=2)
for url in urls:
    limiter.wait()
    response = requests.get(url, timeout=10)
    print(response.status_code, url)
Saída:
1
2
3

200 https://quotes.toscrape.com/page/1/
200 https://quotes.toscrape.com/page/2/
200 https://quotes.toscrape.com/page/3/
Erros comuns
Estes são os erros que mais aparecem em quem está começando com scraping. Todos os tracebacks abaixo foram gerados de verdade (beautifulsoup4 4.15, requests 2.34, Python 3.10).
1. AttributeError: ‘NoneType’ object has no attribute ‘text’
O erro mais comum de todos. find() e select_one() devolvem None quando não encontram nada, e None não tem .text:
1
2
3
4
5
6

from bs4 import BeautifulSoup

html = '<div class="produto"><h2>Teclado</h2></div>'
soup = BeautifulSoup(html, "html.parser")

preco = soup.find("span", class_="preco").text
1

AttributeError: 'NoneType' object has no attribute 'text'
Correção: confira se a tag e a classe existem no HTML que você baixou (não no que o navegador mostra) e trate a ausência:
1
2
3

tag_preco = soup.find("span", class_="preco")
preco = tag_preco.get_text(strip=True) if tag_preco else "sem preço"
print(preco)  # sem preço
2. ModuleNotFoundError ao importar o BeautifulSoup
O pacote se chama beautifulsoup4, mas o módulo é bs4. Os imports abaixo falham:
1
2

from BeautifulSoup import BeautifulSoup   # import da versão 3, que não existe mais
import beautifulsoup4                      # nome do pacote, não do módulo
1
2

ModuleNotFoundError: No module named 'BeautifulSoup'
ModuleNotFoundError: No module named 'beautifulsoup4'
Correção: pip install beautifulsoup4 no mesmo ambiente virtual em que o script roda, e no código from bs4 import BeautifulSoup. Se aparecer No module named 'bs4', o pacote não está instalado no Python que está executando o script.
3. requests.exceptions.HTTPError e ConnectionError
requests.get() não lança erro quando a página responde 404 ou 500: ele devolve a resposta normalmente, e você acaba raspando uma página de erro. Chame raise_for_status() para transformar status 4xx/5xx em exceção:
1
2
3
4
5

import requests

resposta = requests.get("https://books.toscrape.com/pagina-que-nao-existe.html", timeout=10)
print(resposta.status_code)  # 404, mas nenhum erro foi lançado!
resposta.raise_for_status()
1

requests.exceptions.HTTPError: 404 Client Error: Not Found for url: https://books.toscrape.com/pagina-que-nao-existe.html
Já quando o domínio não existe, a internet caiu ou o servidor recusa a conexão, o erro é outro:
1
2
3

import requests

resposta = requests.get("https://site-que-nao-existe.invalid/", timeout=10)
1

requests.exceptions.ConnectionError: HTTPSConnectionPool(host='site-que-nao-existe.invalid', port=443): Max retries exceeded with url: / (Caused by NameResolutionError("HTTPSConnection(host='site-que-nao-existe.invalid', port=443): Failed to resolve 'site-que-nao-existe.invalid' ([Errno -2] Name or service not known)"))
Correção: trate cada caso separadamente:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17

import requests

def baixar_html(url):
    try:
        resposta = requests.get(url, timeout=10)
        resposta.raise_for_status()
        return resposta.text
    except requests.exceptions.HTTPError as erro:
        print(f"Página respondeu com erro: {erro}")
    except requests.exceptions.ConnectionError:
        print(f"Não foi possível conectar em {url}")
    except requests.exceptions.Timeout:
        print(f"{url} demorou demais para responder")
    return None

baixar_html("https://books.toscrape.com/pagina-que-nao-existe.html")
baixar_html("https://site-que-nao-existe.invalid/")
1
2

Página respondeu com erro: 404 Client Error: Not Found for url: https://books.toscrape.com/pagina-que-nao-existe.html
Não foi possível conectar em https://site-que-nao-existe.invalid/
4. O elemento aparece no navegador, mas o BeautifulSoup não acha (conteúdo carregado por JavaScript)
Aqui não há traceback: a busca simplesmente volta vazia. A página quotes.toscrape.com/js/ mostra as mesmas citações no navegador, mas elas são montadas por JavaScript:
1
2
3
4
5
6
7
8

import requests
from bs4 import BeautifulSoup

resposta = requests.get("https://quotes.toscrape.com/js/", timeout=10)
soup = BeautifulSoup(resposta.text, "html.parser")

print(len(soup.select("div.quote")))       # 0 - as citações não estão no HTML
print("var data" in resposta.text)         # True - os dados vêm num <script>
Correção: primeiro olhe o HTML cru (print(resposta.text) ou “Exibir código-fonte” no navegador, não o painel Elements do DevTools). Muitas vezes os dados estão num JSON dentro de um <script> ou numa API que a página chama (aba Network do DevTools). Neste caso dá para ler o JSON direto:
1
2
3
4
5
6
7
8
9
10
11

import json
import re

import requests

resposta = requests.get("https://quotes.toscrape.com/js/", timeout=10)
bloco = re.search(r"var data = (\[.*?\]);", resposta.text, re.DOTALL).group(1)
citacoes = json.loads(bloco)

print(len(citacoes))                      # 10
print(citacoes[0]["author"]["name"])      # Albert Einstein
Se não houver JSON acessível, use uma ferramenta que controla um navegador de verdade, como Playwright ou Selenium.
5. KeyError ao ler um atributo que não existe
tag["href"] funciona como um dicionário: se o atributo não existir, dá KeyError:
1
2
3
4

from bs4 import BeautifulSoup

soup = BeautifulSoup('<a name="topo">Topo</a>', "html.parser")
print(soup.a["href"])
1

KeyError: 'href'
Correção: use soup.a.get("href"), que devolve None, ou filtre só as tags que têm o atributo: soup.find_all("a", href=True).
Exercícios resolvidos
Todos os exercícios usam HTML embutido no próprio código, então rodam sem internet. Tente resolver antes de abrir a solução.
Exercício 1. Dado o HTML <html><head><title>Loja do Pythonista</title></head><body><h1>Ofertas</h1></body></html>, imprima o conteúdo da tag <title> e o texto do <h1>.
Ver solução
1
2
3
4
5
6
7

from bs4 import BeautifulSoup

html = "<html><head><title>Loja do Pythonista</title></head><body><h1>Ofertas</h1></body></html>"
soup = BeautifulSoup(html, "html.parser")

print(soup.title.string)
print(soup.find("h1").text)
Saída: Loja do Pythonista e Ofertas (uma por linha)
soup.title é um atalho para soup.find("title"), e .string devolve o texto quando a tag tem um único filho de texto.
Exercício 2. Extraia uma lista com os href de todos os links do menu abaixo, ignorando o <a> que não tem href.
1
2
3
4
5
6

<nav>
  <a href="/">Início</a>
  <a href="/blog">Blog</a>
  <a>Sem link</a>
  <a href="/contato">Contato</a>
</nav>
Ver solução
1
2
3
4
5
6
7
8
9
10
11
12
13
14

from bs4 import BeautifulSoup

html = """
<nav>
  <a href="/">Início</a>
  <a href="/blog">Blog</a>
  <a>Sem link</a>
  <a href="/contato">Contato</a>
</nav>
"""
soup = BeautifulSoup(html, "html.parser")

links = [a["href"] for a in soup.find_all("a", href=True)]
print(links)
Saída: ['/', '/blog', '/contato']
O filtro href=True traz só as tags que têm o atributo, então a["href"] nunca dá KeyError.
Exercício 3 (estilo prova). Considere o código:
1
2
3
4

from bs4 import BeautifulSoup

soup = BeautifulSoup('<div><p class="a">Oi</p></div>', "html.parser")
print(soup.find("p", class_="x"))
O que é impresso?
a) []
b) None
c) uma string vazia
d) AttributeError
Ver solução
1
2
3
4
5

from bs4 import BeautifulSoup

soup = BeautifulSoup('<div><p class="a">Oi</p></div>', "html.parser")
print(soup.find("p", class_="x"))
print(soup.find_all("p", class_="x"))
Saída: None e depois []
Resposta: b. find() devolve None quando não acha nada; quem devolve lista vazia é find_all(). O AttributeError só apareceria se você tentasse acessar .text nesse None.
Exercício 4. Some os preços do carrinho abaixo. Atenção ao formato brasileiro (R$ 1.199,90).
1
2
3
4
5

<ul class="carrinho">
  <li><span class="nome">Caderno</span> <span class="preco">R$ 12,50</span></li>
  <li><span class="nome">Caneta</span> <span class="preco">R$ 3,20</span></li>
  <li><span class="nome">Mochila</span> <span class="preco">R$ 1.199,90</span></li>
</ul>
Ver solução
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17

from bs4 import BeautifulSoup

html = """
<ul class="carrinho">
  <li><span class="nome">Caderno</span> <span class="preco">R$ 12,50</span></li>
  <li><span class="nome">Caneta</span> <span class="preco">R$ 3,20</span></li>
  <li><span class="nome">Mochila</span> <span class="preco">R$ 1.199,90</span></li>
</ul>
"""
soup = BeautifulSoup(html, "html.parser")

def para_float(texto):
    return float(texto.replace("R$", "").replace(".", "").replace(",", ".").strip())

precos = [para_float(s.text) for s in soup.select("ul.carrinho .preco")]
print(precos)
print(f"Total: R$ {sum(precos):.2f}")
Saída: [12.5, 3.2, 1199.9] e Total: R$ 1215.60
A ordem das trocas importa: primeiro remova o ponto de milhar, depois troque a vírgula decimal por ponto. Invertendo, 1.199,90 viraria 1.199.90 e o float() falharia.
Exercício 5 (estilo prova). Dado o HTML e o código abaixo, o que é impresso?
1
2
3
4
5
6
7
8
9
10
11

from bs4 import BeautifulSoup

html = """
<ul id="menu">
  <li><a href="/inicio">Início</a></li>
  <li class="ativo"><a href="/cursos">Cursos</a></li>
  <li><a href="/blog">Blog</a></li>
</ul>
"""
soup = BeautifulSoup(html, "html.parser")
print(soup.select_one("ul#menu li.ativo a")["href"])
a) /inicio
b) /cursos
c) ['/cursos']
d) KeyError
Ver solução
Saída: /cursos
Resposta: b. O seletor lê-se “o <a> dentro do <li> com classe ativo, dentro da <ul> com id menu”. select_one() devolve uma única tag (não uma lista, por isso não é a c), e o <a> encontrado tem href, então não há KeyError.
Exercício 6. Converta a tabela HTML abaixo em uma lista de dicionários, usando o cabeçalho como chaves.
1
2
3
4
5
6

<table id="notas">
  <tr><th>Aluno</th><th>Nota</th></tr>
  <tr><td>Ana</td><td>9.5</td></tr>
  <tr><td>Bruno</td><td>7.0</td></tr>
  <tr><td>Carla</td><td>8.25</td></tr>
</table>
Ver solução
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21

from bs4 import BeautifulSoup

html = """
<table id="notas">
  <tr><th>Aluno</th><th>Nota</th></tr>
  <tr><td>Ana</td><td>9.5</td></tr>
  <tr><td>Bruno</td><td>7.0</td></tr>
  <tr><td>Carla</td><td>8.25</td></tr>
</table>
"""
soup = BeautifulSoup(html, "html.parser")

linhas = soup.select("table#notas tr")
cabecalho = [th.get_text(strip=True).lower() for th in linhas[0].find_all("th")]

alunos = []
for linha in linhas[1:]:
    valores = [td.get_text(strip=True) for td in linha.find_all("td")]
    alunos.append(dict(zip(cabecalho, valores)))

print(alunos)
Saída: [{'aluno': 'Ana', 'nota': '9.5'}, {'aluno': 'Bruno', 'nota': '7.0'}, {'aluno': 'Carla', 'nota': '8.25'}]
zip() casa cada nome de coluna com o valor da mesma posição e dict() monta o dicionário. Os valores continuam sendo strings; converta com float() se for fazer contas. Essa lista de dicionários é exatamente o formato que o csv.DictWriter e o json.dump esperam.
Exercício 7. Simule uma paginação sem internet: o dicionário SITE faz o papel do servidor. Comece em /page/1/, colete o texto de todos os p.item e siga o link li.next a até ele não existir mais.
Ver solução
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21

from bs4 import BeautifulSoup

# "Site" falso: cada chave é uma URL e cada valor é o HTML da página
SITE = {
    "/page/1/": '<p class="item">A</p><p class="item">B</p><li class="next"><a href="/page/2/">Próxima</a></li>',
    "/page/2/": '<p class="item">C</p><li class="next"><a href="/page/3/">Próxima</a></li>',
    "/page/3/": '<p class="item">D</p><p class="item">E</p>',
}

def baixar(url):
    return SITE[url]  # no mundo real: requests.get(url, timeout=10).text

url = "/page/1/"
itens = []
while url:
    soup = BeautifulSoup(baixar(url), "html.parser")
    itens += [p.text for p in soup.select("p.item")]
    proximo = soup.select_one("li.next a")
    url = proximo["href"] if proximo else None

print(itens)
Saída: ['A', 'B', 'C', 'D', 'E']
É o mesmo padrão da seção de paginação: o laço para quando select_one() devolve None na última página. Isolar o download numa função (baixar) também facilita testar o scraper sem depender do site.
Exercício 8. Imprima nome e preço de cada produto. Quando o preço não existir, mostre indisponível em vez de deixar o programa quebrar.
1
2
3

<div class="produto"><h2>Monitor</h2><span class="preco">R$ 900,00</span></div>
<div class="produto"><h2>Webcam</h2></div>
<div class="produto"><h2>Headset</h2><span class="preco">R$ 250,00</span></div>
Ver solução
1
2
3
4
5
6
7
8
9
10
11
12
13
14

from bs4 import BeautifulSoup

html = """
<div class="produto"><h2>Monitor</h2><span class="preco">R$ 900,00</span></div>
<div class="produto"><h2>Webcam</h2></div>
<div class="produto"><h2>Headset</h2><span class="preco">R$ 250,00</span></div>
"""
soup = BeautifulSoup(html, "html.parser")

for produto in soup.select("div.produto"):
    nome = produto.h2.get_text(strip=True)
    tag_preco = produto.select_one(".preco")
    preco = tag_preco.get_text(strip=True) if tag_preco else "indisponível"
    print(f"{nome}: {preco}")
Saída:
1
2
3

Monitor: R$ 900,00
Webcam: indisponível
Headset: R$ 250,00
Buscar o preço dentro de cada produto (produto.select_one) em vez de no documento inteiro garante que cada nome fique com o seu preço, e o teste if tag_preco evita o AttributeError da seção de erros comuns.
Até a próxima vez, continue programando e se divertindo! 🕷️
Conclusão
Neste guia sobre BeautifulSoup, você aprendeu:
✅ Conceitos fundamentais - Crawler vs Parser
✅ Instalação e setup - BeautifulSoup + requests
✅ Métodos principais - find(), find_all(), select()
✅ Projeto prático - Scraping de citações e paginação
✅ Casos avançados - Headers, retry, dados estruturados
✅ Comparações - BeautifulSoup vs Selenium vs Playwright vs Scrapy
✅ Boas práticas - robots.txt, termos de uso, rate limiting, tratamento de erros
Principais lições:
- BeautifulSoup é ideal para iniciantes e sites estáticos
- Use lxml parser para melhor performance
- Sempre trate erros e implemente retry
- Respeite rate limits para evitar bloqueios
- Para JavaScript, use Selenium ou Playwright
Próximos passos:
- Explore Web Scraping com IA (LangChain)
- Aprenda sobre APIs vs Scraping
- Estude Scrapy para projetos grandes
- Pratique com datasets reais
Perguntas frequentes
O que é web scraping com Python?
Web scraping (raspagem de dados) é a técnica de baixar páginas da web e extrair delas informações de forma automática, como preços, títulos ou links. Em Python, o caminho mais comum é usar a biblioteca requests para baixar o HTML (requests.get(url)) e a biblioteca BeautifulSoup para interpretar esse HTML e localizar os dados com find(), find_all() ou select().
Como instalar e importar o BeautifulSoup no Python?
Instale com pip install beautifulsoup4 (de preferência dentro de um ambiente virtual) e, para baixar páginas, pip install requests. No código, o import é from bs4 import BeautifulSoup. Escrever import beautifulsoup4 ou from BeautifulSoup import BeautifulSoup gera ModuleNotFoundError, porque o pacote se chama beautifulsoup4, mas o módulo importado se chama bs4.
Qual a diferença entre find, find_all e select no BeautifulSoup?
find() devolve o primeiro elemento que casa com a busca, ou None se não achar nada. find_all() devolve uma lista com todos os elementos encontrados (lista vazia se não houver nenhum). select() faz a mesma busca de find_all(), mas usando seletores CSS, como div.produto > span.preco, e select_one() é a versão que devolve só o primeiro resultado ou None.
Como extrair o texto e os atributos de uma tag com BeautifulSoup?
Para o texto, use tag.get_text(strip=True) (ou tag.text, que mantém espaços e quebras de linha). Para atributos, use tag['href'], que lança KeyError se o atributo não existir, ou tag.get('href'), que devolve None nesse caso. O dicionário completo de atributos fica em tag.attrs, e o atributo class sempre vem como lista.
Por que o BeautifulSoup não encontra um elemento que aparece no navegador?
Normalmente porque o conteúdo é montado por JavaScript depois que a página carrega. O requests baixa apenas o HTML inicial e o BeautifulSoup não executa JavaScript, então o elemento não existe no texto que você recebeu. Confira com print(resposta.text): se os dados não estiverem lá, procure a API ou o JSON que a página usa, ou use uma ferramenta que controla um navegador, como Playwright ou Selenium.
Como resolver o erro AttributeError: ‘NoneType’ object has no attribute ‘text’?
Esse erro acontece quando find() ou select_one() não encontra o elemento e devolve None, e você tenta acessar .text nesse None. Confira se a tag, a classe e o seletor estão certos no HTML baixado e trate a ausência antes de ler o texto: tag = soup.find('span', class_='preco') e depois preco = tag.get_text(strip=True) if tag else None.
Web scraping é legal?
Depende do que é coletado, de como e para quê. Em geral, coletar dados públicos em ritmo moderado é uma prática comum, mas é preciso respeitar os termos de uso do site, o arquivo robots.txt, direitos autorais e leis de proteção de dados pessoais, como a LGPD no Brasil. Prefira APIs oficiais quando existirem, não sobrecarregue o servidor e, em caso de dúvida para um uso concreto, consulte um profissional da área jurídica.
Em web scraping com Python, qual biblioteca baixa a página e qual faz o parse do HTML?
A biblioteca requests faz a requisição HTTP e baixa o HTML (requests.get(url).text), e a BeautifulSoup faz o parse, transformando o HTML em uma árvore onde você busca tags com find(), find_all() e select(). O BeautifulSoup sozinho não acessa a internet e não executa JavaScript.
Por Vinícius Ramos em
Engenheiro de Computação pela UnB com especialização em Inteligência Artificial. Sr. Software Engineer com 10+ anos de experiência desenvolvendo sistemas críticos em Python e Django. Atuei no Banco do Brasil liderando equipes para monitoramento de mainframe, trabalhei como desenvolvedor sênior em projetos forenses para a Polícia Federal, e atualmente sou engenheiro de software na Labcorp (Estados Unidos), desenvolvendo soluções escaláveis para testes genéticos. Fundador da Python Academy, compartilhando conhecimento técnico com a comunidade brasileira desde 2018.
 Bora se conectar no LinkedIn!
vinicius-aramos




 "Porque o Senhor dá a sabedoria, e da sua boca vem a inteligência e o entendimento" Pv 2:6