

✅ Artigo atualizado em Setembro 2026 Nova seção sobre CSV brasileiro com
sep=";",decimal=",",encodingena_values(a introdução prometia e não tinha exemplo),usecolsno exemplo de arquivos grandes e saídas conferidas no pandas 3.0.6 com Python 3.13.
Olá, futuro Cientista de Dados!
pd.read_csv() é a função mais usada em Data Science! Aprenda parâmetros essenciais, otimizações e casos reais.
Neste guia:
- ✅ Parâmetros essenciais - sep, header, dtype, encoding
- ✅ Grandes arquivos - chunksize, usecols
- ✅ Dados ausentes - na_values, keep_default_na
- ✅ Casos práticos - Múltiplos CSVs, parse_dates
No post de hoje vamos começar a nossa jornada nessa área que tem chamado muita atenção de profissionais e de empresas!
E não é à toa: o mercado está cada vez mais procurando profissionais com esse perfil, no Brasil e no mundo.
Até a Harvard Business Review concorda comigo!
Esse post dá início à uma série de posts da biblioteca que é considerada por muitos um dos motivos de Python ser cada vez mais utilizado por cientista de dados: o poderoso Pandas! 
Mas calma! Sem medo galera!
Você vai ver que, apesar de versátil - como as boas bibliotecas pythonistas - Pandas é extremamente simples de utilizar.
Entendendo o básico de dataframes, series e índices, vocês dominarão o mundo do data wrangling (nome bonito para: FUÇAR OS DADOS  ).
Mas antes de aprender isso tudo em outros posts, vamos direto ao assunto para quebrar logo o gelo e começar com o pé direito: importar arquivos CSV e visualizar os dados!
Vá Direto ao Assunto…
- Arquivo CSV
- Instalação do Pandas
- Importar Arquivo CSV com Pandas
- Bônus: e exportar para CSV?
- Casos Práticos Avançados
- Pandas vs CSV Nativo
Arquivo CSV
Cara, não devo saber nada mesmo, o que é um arquivo CSV???
Não tema meu amigo pythonista, um arquivos CSV nada mais é que um arquivo de texto com valores separados por vírgula (Comma Separated Values).
Ou seja, nada mais é que um arquivo onde cada linha possui valores separados por vírgulas. Bora de exemplo?
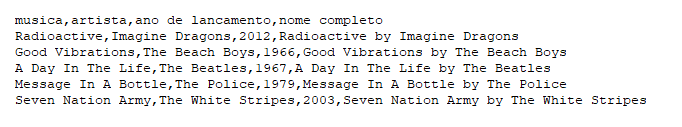
O arquivo mostra os dados de 5 músicas, com banda e ano de lançamento, além da última coluna que contém o nome completo.
Percebam que a primeira linha é o cabeçalho, com o nome descritivo de cada coluna.
Viu? Moleza, não é?
Claro que, na maioria dos casos práticos, os arquivo terão milhares ou mesmo milhões de linhas. Contudo, enquanto seu computador tiver memória para aguentar, o Pandas estará do seu lado!
Quando não estiver do nosso lado, bem, aí é assunto pra um outro post (deixem comentários aqui embaixo se gostariam de um post com esse assunto  )
Vamos então ao que interessa: Pandas!!!
Ops, esse não, produtor!! 
Instalação do Pandas
Caso você utilize o Anaconda, o Pandas já vem instalado por padrão.
Caso contrário, sigam-me os bons.
Vamos instalá-lo utilizando nosso bom e velho pip.
Primeiro, vamos ao básico: ative seu ambiente virtual para começar a instalação.
COMO ASSIM você não usa ambientes virtuais?! 
Se você é desses, já vai lá no post sobre ambientes virtuais pra começarmos direito!
Para instalar o Pandas (após ativar seu ambiente virtual), basta executar o comando:
1

pip install pandas
Voilá, temos nossa ferramenta pronta pra trabalhar!
Agora escolha sua melhor IDE, seu notebook jupyter ou mesmo a linha de comando e mãos à obra - ou melhor - mãos ao código 
Estou desenvolvendo o Ebookr.ai, uma plataforma que transforma suas ideias em ebooks profissionais usando IA - com geração de capa, infográficos e exportação em PDF. Te convido a conhecer!
Importar Arquivo CSV com Pandas
Primeramente temos que importar a biblioteca!
Sabemos que na hora de importar qualquer biblioteca em Python, podemos criar um apelido (alias) para facilitar o acesso.
No caso do Pandas, o padrão é chamá-lo carinhosamente de ‘pd’:
1

>>> import pandas as pd
Com o Pandas importado, vamos utilizar o método read_csv(), passando como parâmetro o arquivo CSV que queremos importar.
No nosso caso, vamos usar o arquivo bandas.csv, que você pode clicar aqui para baixá-lo.
O método retorna uma estrutura tabular que é a base do Pandas, chamada de Dataframe.
Um dataframe nada mais é que uma estrutura bidimensional, com linhas e colunas.
Imagine uma planilha do Excel ou uma tabela do seu banco de dados e terá uma boa noção de como ele se comporta:
1
2

>>> import pandas as pd
>>> musicas = pd.read_csv('./bandas.csv')
Como assim, só isso?
Sim, jovem padawan!! Mais mole, só sentando na gelatina.
Mas… O que aconteceu?
Nosso querido pandas leu o arquivo CSV, já entendeu que a primeira linha é o cabeçalho, e separou as colunas direitinho pra você!
Ainda duvida?
Vamos rodar o comando abaixo para verificar as 5 primeiras linhas do nosso Dataframe com músicas do arquivo CSV importado:
1
2
3

>>> import pandas as pd
>>> musicas = pd.read_csv('./bandas.csv')
>>> musicas.head()
E o resultado será:
1
2
3
4
5
6

                musica            artista  ano de lancamento                           nome completo
0          Radioactive    Imagine Dragons               2012          Radioactive by Imagine Dragons
1      Good Vibrations     The Beach Boys               1966       Good Vibrations by The Beach Boys
2    A Day In The Life        The Beatles               1967        A Day In The Life by The Beatles
3  Message In A Bottle         The Police               1979       Message In A Bottle by The Police
4    Seven Nation Army  The White Stripes               2003  Seven Nation Army by The White Stripes
Uai… E essa primeira coluna com valores de 0 a 4, que não estava no arquivo original!?!
Esse padawan é esperto!
Veremos num próximo post que o Pandas não cria “nomes” somente para as colunas, mas também para as linhas!!
Esse “nome” é chamado de índice e será muito importante para realizarmos seleções de partes dos dados de um Dataframe Pandas.
Maaaaaas… Cenas para um próximo capítulo :bowtie:
Está curtindo esse conteúdo? 
Que tal receber 30 dias de conteúdo direto na sua Caixa de Entrada?
Claro que esse CSV já estava todo arrumadinho, limpinho e cheiroso. Mas não se engane: nem sempre será assim.
Um dos trabalhos do cientista de dados é limpar os dados, que consiste em:
- Consertar codificação de dados de entrada;
- Converter tipos;
- Configurar separadores de decimais;
- Limpar caracteres indesejados;
- Tratar dados faltantes entre outros vários problemas.
Podemos já tratar alguns desses problemas no momento da importação dos dados, no próprio método read_csv()
Um exemplo de parâmetro é dizer para o Pandas que não queremos que a primeira linha seja considerada o cabeçalho, mas sim parte dos dados.
Para isso, podemos executar o método read_csv() com o parâmetro header com o valor None:
1
2

>>> musicas_sem_cabecalho = pd.read_csv('./bandas.csv', header=None)
>>> musicas_sem_cabecalho.head()
Com esse parâmetro, temos o resultado:
1
2
3
4
5
6

                     0                1                  2                                  3
0               musica          artista  ano de lancamento                      nome completo
1          Radioactive  Imagine Dragons               2012     Radioactive by Imagine Dragons
2      Good Vibrations   The Beach Boys               1966  Good Vibrations by The Beach Boys
3    A Day In The Life      The Beatles               1967   A Day In The Life by The Beatles
4  Message In A Bottle       The Police               1979  Message In A Bottle by The Police
Percebam que agora temos outros nomes para cada coluna! O Pandas cria os nomes automaticamente, começando do 0.
Separador, decimal e encoding: CSV brasileiro
O bandas.csv segue o padrão americano: vírgula separando colunas e ponto como separador decimal. Mas muitos CSVs brasileiros (exportados pelo Excel em português, por sistemas de ERP ou por portais de dados públicos) vêm assim:
1
2
3
4

produto;preço;quantidade
Café;1.234,50;10
Pão de queijo;7,90;-
Açúcar;4,25;3
Colunas separadas por ponto e vírgula, vírgula como separador decimal, ponto como separador de milhar, um - indicando valor ausente e, muitas vezes, o arquivo salvo em Latin-1 (cp1252 no Windows) em vez de UTF-8.
Se tentarmos ler esse arquivo vendas_br.csv só com pd.read_csv('vendas_br.csv'), o Pandas usa o encoding padrão (utf-8) e falha logo nos acentos:
1

UnicodeDecodeError: 'utf-8' codec can't decode byte 0xe7 in position 11: invalid continuation byte
Corrigindo só o encoding, o erro some, mas as colunas saem erradas, porque o Pandas continua separando por vírgula (e a vírgula agora é a dos decimais):
1
2
3
4
5

>>> pd.read_csv('vendas_br.csv', encoding='latin-1')
                produto;preço;quantidade
Café;1.234                         50;10
Pão de queijo;7                     90;-
Açúcar;4                            25;3
A solução é informar cada detalhe do formato para o read_csv():
1
2
3
4
5
6
7
8
9
10
11
12
13

import pandas as pd

df = pd.read_csv(
    "vendas_br.csv",
    sep=";",             # colunas separadas por ponto e vírgula
    decimal=",",         # vírgula como separador decimal
    thousands=".",       # ponto como separador de milhar
    encoding="latin-1",  # arquivo salvo em Latin-1 (comum em exportações do Excel no Windows)
    na_values=["-"],     # "-" também vira dado ausente (NaN)
)

print(df)
print(df.dtypes)
E o resultado:
1
2
3
4
5
6
7
8

         produto    preço  quantidade
0           Café  1234.50        10.0
1  Pão de queijo     7.90         NaN
2         Açúcar     4.25         3.0
produto           str
preço         float64
quantidade    float64
dtype: object
Agora sim: preço virou número de verdade (float64), pronto para contas, e o - virou NaN.
Alguns detalhes:
- A coluna
quantidadeviroufloat64(e nãoint64) porque tem um valor ausente: oNaNpadrão do NumPy é um número de ponto flutuante. - No pandas 3.0, colunas de texto aparecem com o tipo
str; no pandas 2.x o mesmoprint(df.dtypes)mostravaobject. - O
na_valuesacrescenta valores à lista padrão de ausentes do Pandas (string vazia,NaN,N/A,NULLetc.). Se quiser que só os valores da sua lista viremNaN, use tambémkeep_default_na=False. - Se o arquivo estiver em UTF-8, basta trocar para
encoding="utf-8"(que já é o padrão). Na dúvida entrelatin-1eutf-8, tente primeiroutf-8: se derUnicodeDecodeError, o arquivo provavelmente é Latin-1/cp1252. - Não sabe o separador?
sep=Nonecomengine="python"faz o Pandas tentar detectar o delimitador usando ocsv.Snifferdo Python, mas é mais lento e pode errar - quando você conhece o formato, informe osep.
Todos esses parâmetros estão descritos na documentação oficial do read_csv().
O Pandas resolve muita coisa, mas ele se apoia direto na base do Python: funções, estruturas de dados, arquivos. Para fortalecer esses fundamentos com prática guiada, conheça a Jornada Python:
Domine Python: A Linguagem da Inteligência Artificial, do Desenvolvimento Web e das Carreiras do Futuro.
A mais completa formação para você se tornar um especialista em Python, pronto para construir desde aplicações web robustas com Django até projetos de Inteligência Artificial e Ciência de Dados .
Bônus: e exportar para CSV?
Uma vez com o Dataframe Pandas em memória (após a execução do read_csv()), podemos escrever um arquivo CSV de saída utilizando o método to_csv(), da seguinte forma:
1

>>> musicas_sem_cabecalho.to_csv('./bandas_sem_cabecalho.csv')
Prontinho! temos nosso arquivo CSV exportado!
Casos Práticos Avançados
1. Ler Arquivos Grandes em Chunks
1
2
3
4
5
6
7
8
9
10
11
12
13
14

import pandas as pd

# Arquivo muito grande? Use chunks!
chunk_size = 10000
chunks = []

# usecols lê só as colunas necessárias (menos memória e mais rápido)
for chunk in pd.read_csv('vendas_gigante.csv', chunksize=chunk_size, usecols=['id', 'valor']):
    # Processar cada chunk
    chunk_filtrado = chunk[chunk['valor'] > 100]
    chunks.append(chunk_filtrado)

df_final = pd.concat(chunks, ignore_index=True)
print(f"Total de linhas: {len(df_final)}")
2. Combinar Múltiplos CSVs
1
2
3
4
5
6
7
8
9
10

import pandas as pd
from pathlib import Path

# Ler todos os CSVs de uma pasta
pasta = Path('./dados/')
arquivos_csv = pasta.glob('vendas_*.csv')

dfs = [pd.read_csv(arquivo) for arquivo in arquivos_csv]
df_completo = pd.concat(dfs, ignore_index=True)
print(df_completo.shape)
3. Parse de Datas Automático
1
2
3
4
5
6
7
8
9
10
11

import pandas as pd

df = pd.read_csv(
    'vendas.csv',
    parse_dates=['data_venda', 'data_entrega'],  # Converte para datetime
    date_format='%Y-%m-%d'  # Pandas 2.0+
)

print(df.dtypes)
# data_venda    datetime64[us]   (no pandas 2.x: datetime64[ns])
# data_entrega  datetime64[us]
4. Otimizar Tipos de Dados
1
2
3
4
5
6
7
8
9
10
11
12
13
14

import pandas as pd

# Especificar dtypes economiza memória
df = pd.read_csv(
    'dados.csv',
    dtype={
        'id': 'int32',
        'quantidade': 'int16',
        'preco': 'float32',
        'categoria': 'category'
    }
)

print(df.memory_usage(deep=True))
Pandas vs CSV Nativo
1
2
3
4
5
6
7
8
9
10

import pandas as pd
import csv

# CSV Nativo (baixo nível)
with open('dados.csv', 'r', encoding='utf-8', newline='') as f:
    reader = csv.DictReader(f)
    dados = [row for row in reader]

# Pandas (alto nível) - RECOMENDADO!
df = pd.read_csv('dados.csv')
Quando usar cada um?
✅ Use Pandas quando:
- Precisa análise de dados
- Quer manipulação fácil
- Trabalha com DataFrames
- Precisa performance (numpy backend)
✅ Use csv nativo quando:
- Arquivo muito simples
- Sem dependências externas
- Apenas leitura básica
- Script leve
Conclusão
Neste guia de read_csv(), você aprendeu:
✅ Parâmetros essenciais - sep, header, dtype, encoding
✅ CSV brasileiro - sep=”;”, decimal=”,”, thousands=”.” e na_values
✅ Grandes arquivos - chunksize para processar em partes e usecols para ler só o necessário
✅ Múltiplos CSVs - concat() para unir DataFrames
✅ Parse_dates - Conversão automática de datas
✅ Otimização - dtype para economizar memória
Principais lições:
-
read_csv()é extremamente flexível - Use
chunksizepara arquivos gigantes -
dtypeeconomiza memória -
parse_datesconverte strings para datetime - Pandas é mais poderoso que csv nativo
Próximos passos:
- Aprenda Séries
- Explore DataFrames
- Pratique
DataFrame.to_csv()para exportar (comsep=";"edecimal=","para gerar CSV brasileiro) - Estude
pd.read_excel()para Excel
Primeiro contato com Pandas, o que achou? Fácil, difícil?
Comenta aqui embaixo suas dores e/ou sugestões! A gente quer te ouvir
Esse foi somente o primeiro de muitos posts, pois esse assunto é muito extenso e importante para quem está iniciando a carreira de cientista de dados.
Vamos juntos que o caminho é longo, mas possível e gratificante!
Quer uma base de Python sólida para trabalhar com dados, com manipulação de arquivos e automação em projetos guiados? Conheça nosso curso de Python completo, a Jornada Python.
Antes de terminar: sabia que a gente está no Instagram?
Vai lá e deixe seu comentário, interaja com a gente! Tem posts complementares ao blog e muitos desafios: procurem nos destaques
Até o próximo post!

Por Leon Solon em
Pai, cientista de dados, apaixonado por resolver problemas.
 Bora se conectar no LinkedIn!
leonsolon




 "Porque o Senhor dá a sabedoria, e da sua boca vem a inteligência e o entendimento" Pv 2:6